Дефекты дорог с высоты: от бенчмарка до карты в QGIS
Опубликовано · 9 мин чтения
Моя магистерская работа в НИТУ МИСИС отвечала на практический вопрос: могут ли дрон и детектор объектов заменить человека, который идёт вдоль дороги с планшетом? Из этой работы получились две статьи, небольшое приложение и один урок, к которому я постоянно возвращаюсь: модель с хорошим результатом на бенчмарке сделала в лучшем случае половину работы.
В этом посте: что я построил, какие решения при обучении действительно повлияли на метрики и что произошло, когда модель встретилась со съёмкой, которую никогда не видела.
Задача
Трещины, выбоины и сетка трещин появляются первыми, когда дорога начинает разрушаться. Если их устранить рано, ремонт обходится дёшево. Если оставить, движение и погода превращают их в ремонт, который стоит намного дороже. При этом большинство обследований дорог до сих пор проводят вручную: инженер проходит или проезжает участок и записывает, что видит. Это медленно, мешает движению, и два инженера редко описывают одну и ту же дорогу одинаково.
Дрон пролетает километры дороги за минуты. Если сшить снимки в ортофотоплан, то есть в одно изображение всего участка с географической привязкой, на нём видны трещины шириной в несколько миллиметров. Добавьте обученный детектор, и получится основа для автоматического обследования.
Статьи на эту тему обычно заканчиваются результатом на бенчмарке. Я хотел получить три вещи, которые в них обычно пропускают:
- Какие решения при обучении важны. Чаще всего публикуют одну настроенную конфигурацию. Я хотел понять, какое изменение сколько даёт.
- Что происходит на реальной съёмке. Снимки бенчмарка и ортофотопланы снимают с разной высоты, поэтому одна и та же трещина выглядит для модели разного размера.
- Результат, с которым может работать инженер. Рамки в пиксельных координатах бесполезны тому, кто планирует ремонт. Нужны координаты на карте.
Как всё устроено
Весь проект на одной схеме: на входе данные, четыре этапа, на выходе карта. Дальше в посте я разбираю каждый этап.
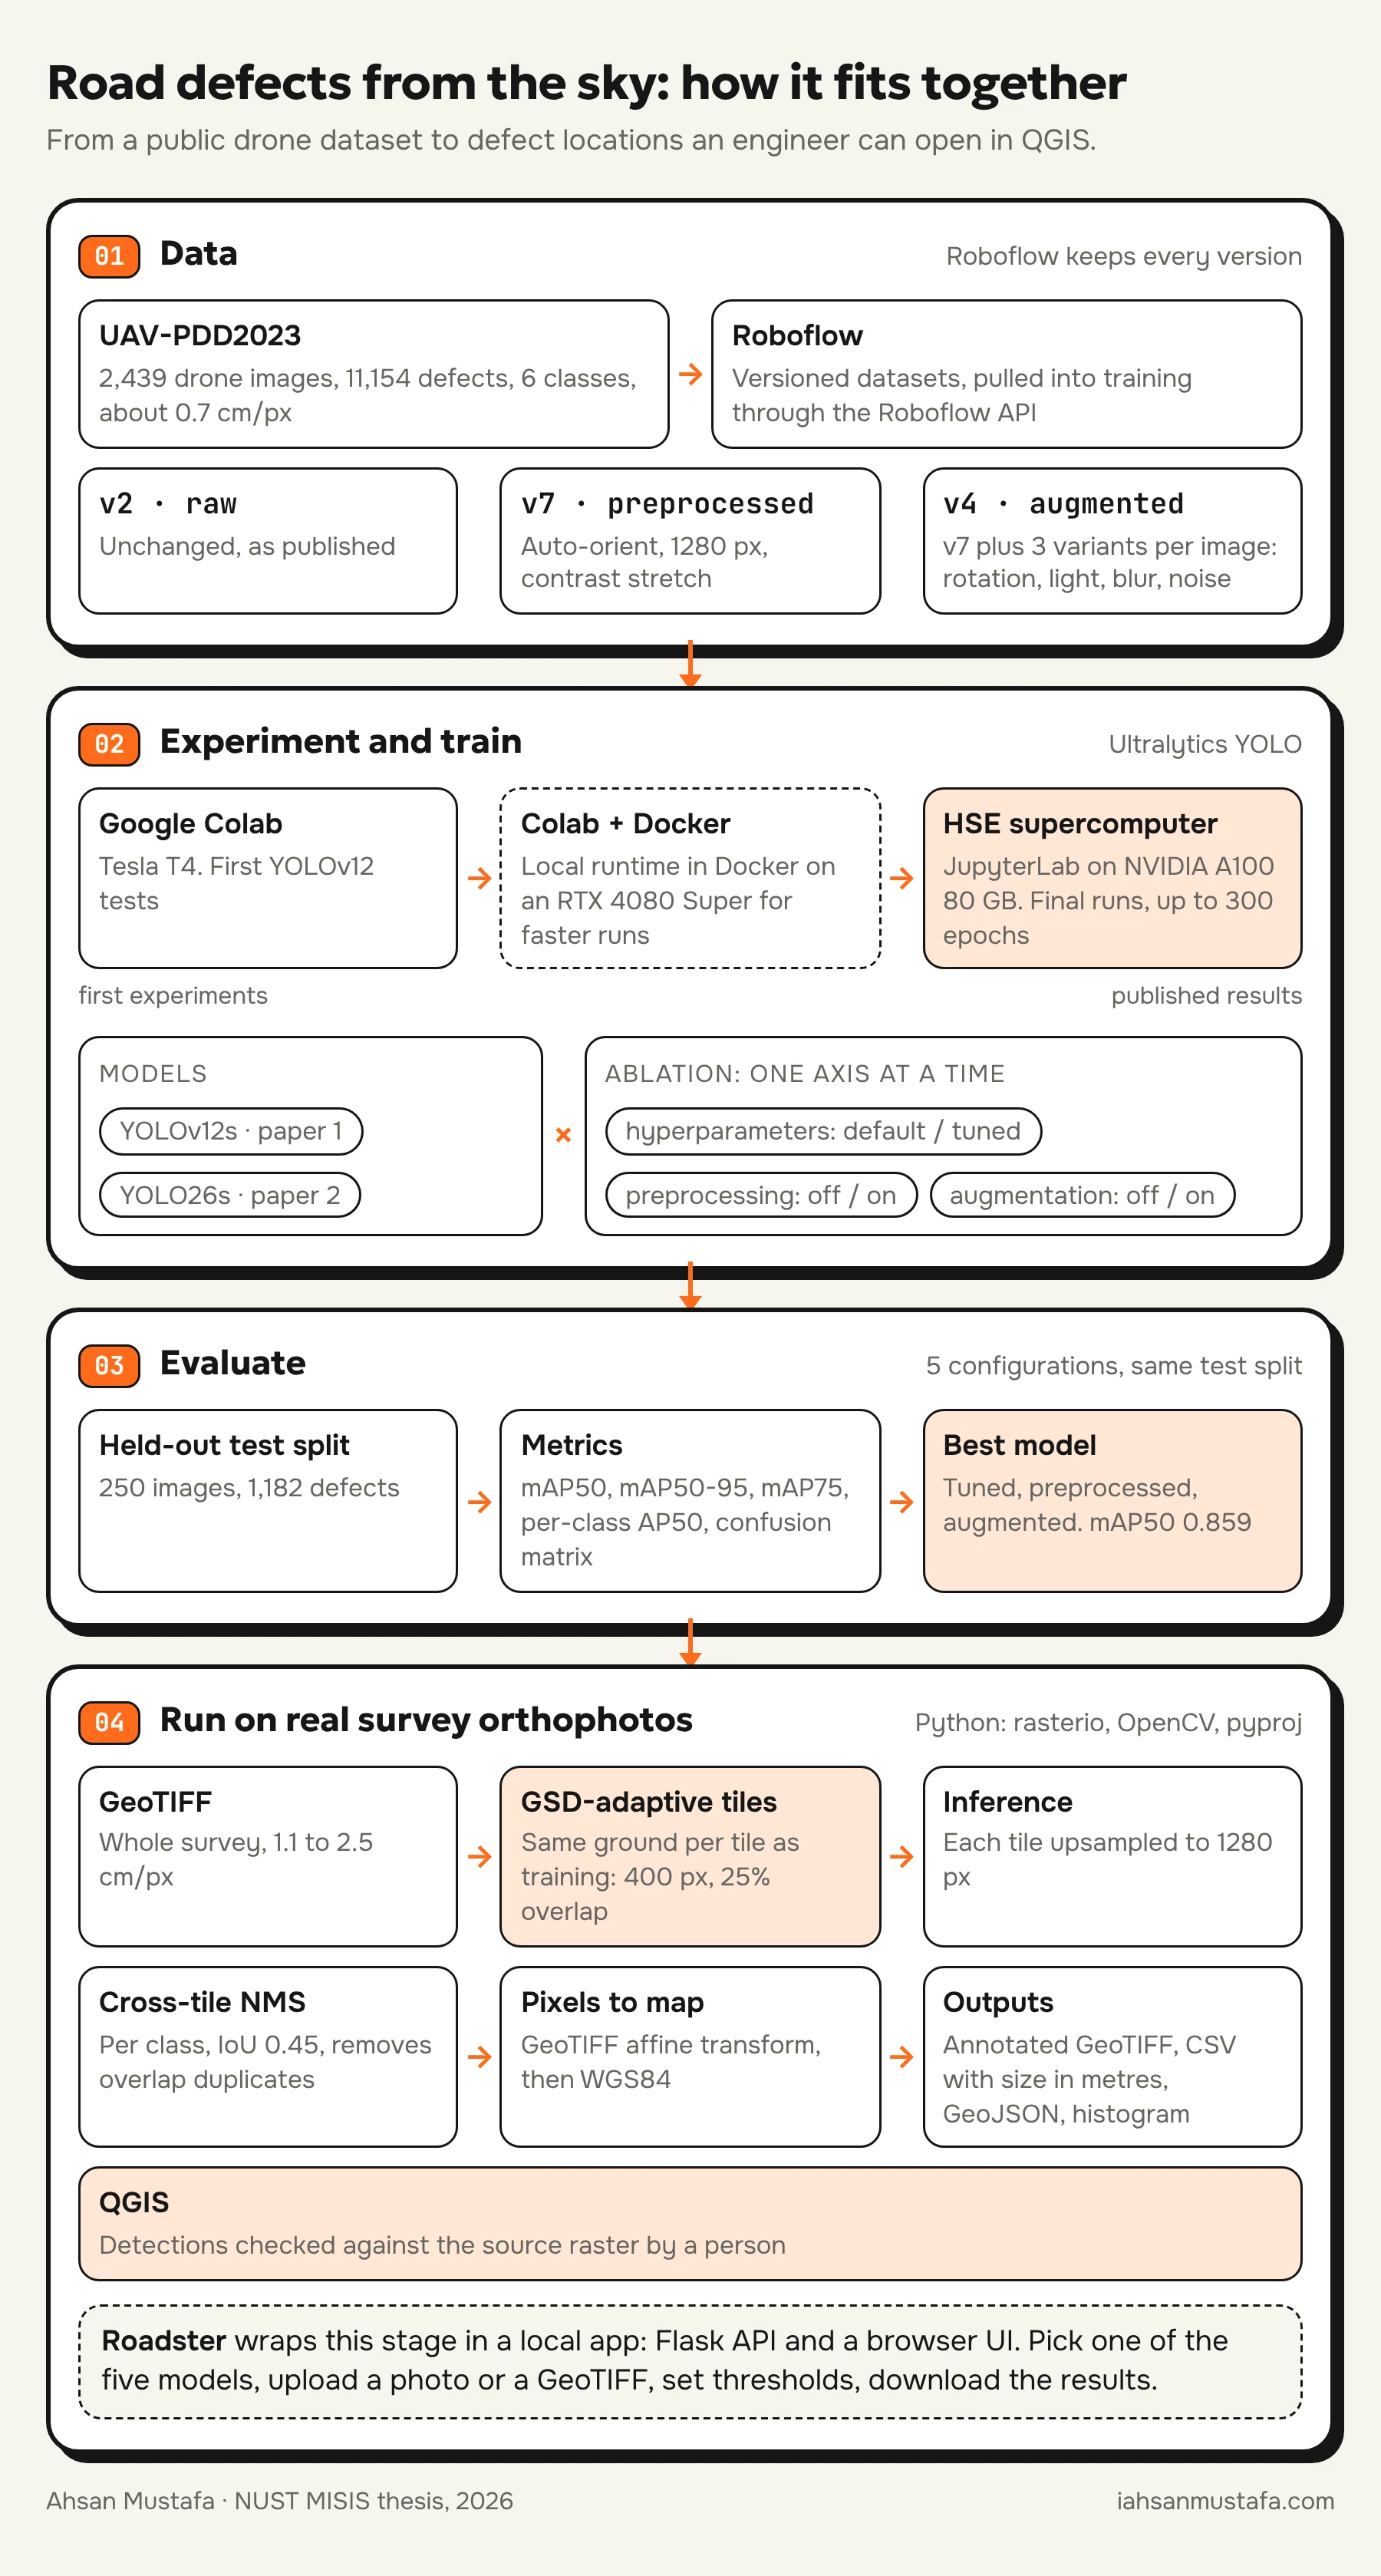
Вычислительные ресурсы росли вместе с проектом. Первые тесты YOLOv12 шли в Google Colab на бесплатной T4. Чтобы экспериментировать быстрее, я подключил Colab к локальной среде в Docker на своей RTX 4080 Super. Опубликованные результаты получены в JupyterLab на суперкомпьютере ВШЭ, на NVIDIA A100 с 80 ГБ памяти. Только так вход 1280 пикселей и обучение на 300 эпох стали реальными.
Roboflow был в центре как хранилище датасетов. Каждый вариант предобработки и аугментации стал отдельной версией датасета, и каждый запуск обучения получал точную версию через API Roboflow. Благодаря этому абляционное исследование было честным: если два запуска различаются, я точно знаю, на какой версии обучался каждый.
Данные
Всё обучение шло на UAV-PDD2023, открытом бенчмарке со снимками дорог в Китае, сделанными с дронов: 2439 изображений, 11 154 размеченных дефекта, шесть классов (сетка трещин, продольная трещина, косая трещина, поперечная трещина, выбоина и заплата).
| Выборка | Изображения | Дефекты |
|---|---|---|
| Обучающая | 1709 | 7689 |
| Валидационная | 480 | 2283 |
| Тестовая | 250 | 1182 |
Классы сильно несбалансированы. У продольных и поперечных трещин тысячи примеров, а у выбоин и косых трещин вместе меньше 1500. Этот дисбаланс заметен во всех результатах ниже.
Первый подход: YOLOv12 и вопрос о цвете
В первой статье, в журнале Light & Engineering, я сравнил две конфигурации YOLOv12s: базовую с входом 640 пикселей без аугментации и улучшенную с входом 1280 пикселей, предобработкой и аугментацией. Улучшенная модель достигла mAP50-95 0,448 против 0,134 у базовой.
Там же мы проверили вопрос, важный для реальных дронов: камеры бывают разными. Что, если камера даёт только один цветовой канал? Мы запустили модели, обученные на RGB, на одноканальных версиях снимков с отдельного полёта, без дообучения. Больше 90% дефектов, найденных в RGB, нашлись и в одном канале. Лучше обученная модель оказалась и более стабильной: число её детекций менялось между каналами от 10 до 20%, а у базовой от 15 до 25%.
Эта статья ответила на вопрос «работает ли это». Но не на вопрос «почему работает». Для этого была вторая.
Абляция: что на самом деле улучшило метрики
Во второй статье, которая сейчас в печати в Moscow University Physics Bulletin и была представлена на DLCP 2026, я перешёл на YOLO26s и менял по одному параметру вдоль трёх осей:
- Гиперпараметры: настройки Ultralytics по умолчанию (DP) или подобранный набор (BP) с входом 1280 пикселей и 300 эпохами.
- Предобработка: без неё (NPP) или автоориентация, приведение к 1280 × 1280 и растяжение контраста (BPP).
- Аугментация: без неё (NAUG) или три аугментированные копии каждого обучающего снимка с небольшими поворотами, изменением яркости и насыщенности, размытием и шумом (BAUG).
Пять конфигураций, все оценены на одной и той же отложенной тестовой выборке:
| Конфигурация | mAP50 | mAP50-95 | mAP75 |
|---|---|---|---|
| Базовая (DP, NPP, NAUG) | 0,547 | 0,271 | 0,218 |
| DP, BPP, NAUG | 0,645 | 0,350 | 0,347 |
| BP, NPP, NAUG | 0,763 | 0,477 | 0,508 |
| DP, BPP, BAUG | 0,769 | 0,480 | 0,539 |
| BP, BPP, BAUG | 0,859 | 0,631 | 0,740 |
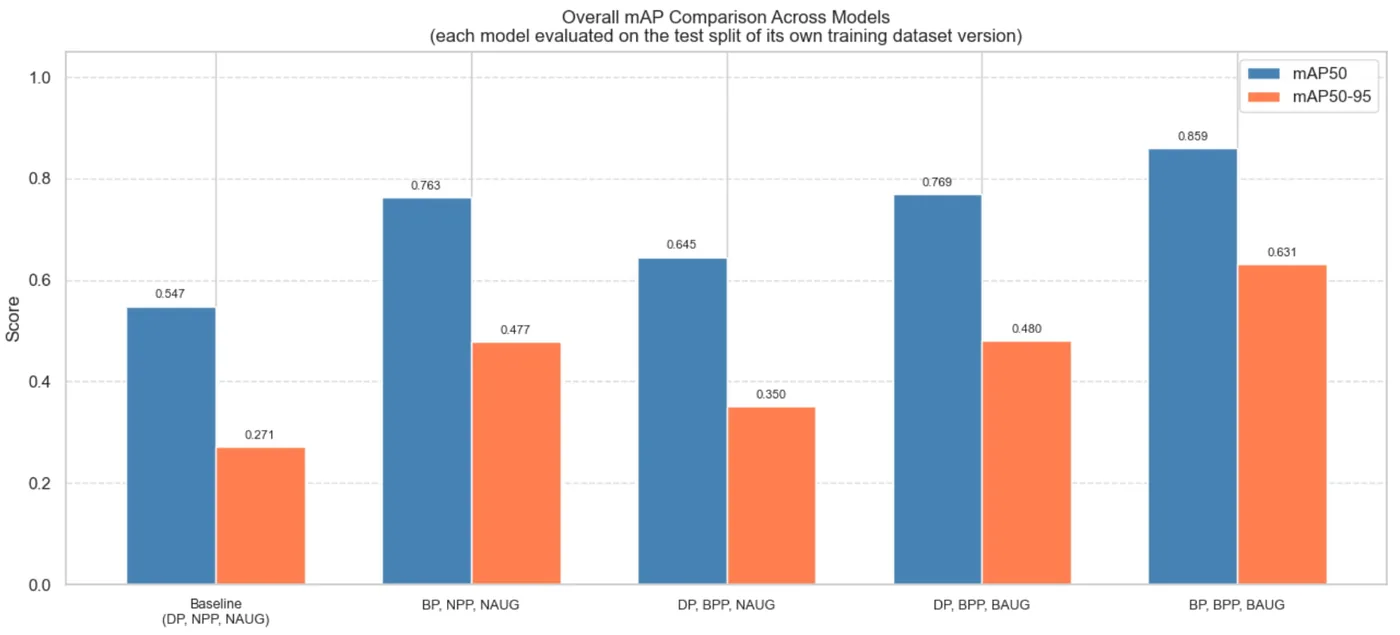
Полная комбинация улучшает mAP50 на 57%, а mAP50-95 на 133% по сравнению с настройками по умолчанию. Одни только подобранные гиперпараметры дают больше двух третей этого прироста.
Здесь есть оговорка, о которой я хочу сказать прямо, и в статье она тоже есть. Подобранные гиперпараметры меняют сразу две вещи: разрешение входа и длительность обучения. Поэтому я могу утверждать, что этот набор даёт самый большой прирост, но не что его даёт одно разрешение. Результаты по классам явно указывают на разрешение, но «явно указывают» не значит «доказано отдельно». Разделить эти два эффекта будет первым экспериментом, который я бы провёл дальше.
По классам
| Класс | AP50 базовой | AP50 лучшей | Прирост |
|---|---|---|---|
| Сетка трещин | 0,623 | 0,949 | +0,326 |
| Продольная трещина | 0,625 | 0,901 | +0,276 |
| Косая трещина | 0,362 | 0,797 | +0,435 |
| Выбоина | 0,446 | 0,774 | +0,328 |
| Заплата | 0,624 | 0,877 | +0,253 |
| Поперечная трещина | 0,605 | 0,857 | +0,252 |
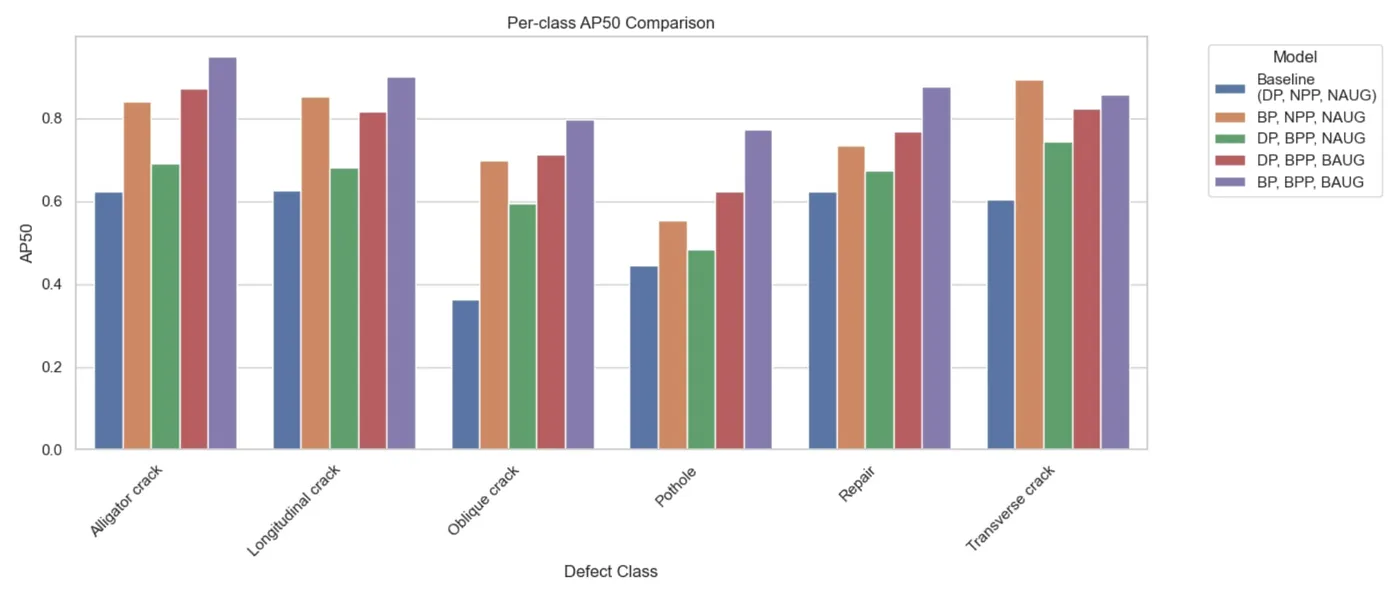
Два класса объясняют всё:
- Косые трещины выиграли больше всех. При 640 пикселях диагональная трещина занимает несколько пикселей в ширину и похожа на продольную. При 1280 пикселях её угол сохраняется, и модель их различает. Это проблема разрешения, а не сложный для обучения класс.
- Выбоины выиграли в основном от аугментации. Это самый редкий класс, и три разные копии каждого примера помогли больше, чем дополнительные пиксели. Он всё ещё самый слабый: на валидационных снимках модель часто даёт выбоинам уверенность от 0,4 до 0,7.
От бенчмарка к настоящей дороге
Это самая интересная для меня часть, и именно её статьи с бенчмарками пропускают.
Проблема масштаба
Пространственное разрешение съёмки (GSD) показывает, сколько земли покрывает один пиксель. UAV-PDD2023 снимали низко, около 0,7 см на пиксель. Ортофотопланы для обследований снимают выше, обычно от 1 до 3 см на пиксель.
Значит, тайл размером 1280 пикселей при 2,5 см/пиксель покрывает 32 метра дороги, а модель училась на тайлах примерно по 9 метров. Выбоина, которая при обучении занимала 50 пикселей, сжимается примерно до 14, и это слишком мало для надёжного обнаружения. Если подать съёмку модели напрямую, она видит совсем другой мир.
Тайлы по земле, а не по пикселям
Решение в том, чтобы выбрать размер тайла так, чтобы он покрывал ту же площадь земли, что и при обучении:
# 1280 px at the training GSD covers ~9 m of road.
# Pick the field tile so it covers the same distance.
tile_px = round(1280 * gsd_train / gsd_field)   # 1280 * 0.7 / 2.5 ≈ 358, rounded up to 400
stride = int(tile_px * 0.75)                    # 25% overlap so no defect is cut in every tile
Тайл в 400 пикселей при 2,5 см/пиксель покрывает 10 метров. Ultralytics перед инференсом увеличивает его до 1280 пикселей, и модель видит трещину примерно того размера, к которому привыкла. Перекрытие в 25% означает, что дефект на краю одного тайла целиком попадает в соседний.
Перекрытие создаёт дубликаты, поэтому после инференса все рамки переводятся в координаты всего изображения, и я запускаю подавление немаксимумов (NMS) по каждому классу на всём ортофотоплане (IoU 0,45). Затем каждая рамка проходит через аффинное преобразование GeoTIFF с помощью rasterio и, если растр в проекции UTM, переводится в WGS84 через pyproj. Ширина и высота в метрах получаются из GSD.
Для каждого ортофотоплана конвейер создаёт:
- GeoTIFF с цветными рамками дефектов,
- CSV с классом, уверенностью, широтой, долготой, шириной, высотой и площадью в м²,
- GeoJSON, который сразу открывается в QGIS,
- гистограмму уверенности.
Три реальных ортофотоплана
Я проверял конвейер на трёх ортофотопланах из другого региона, снятых выше, чем данные для обучения, и не участвовавших в обучении.
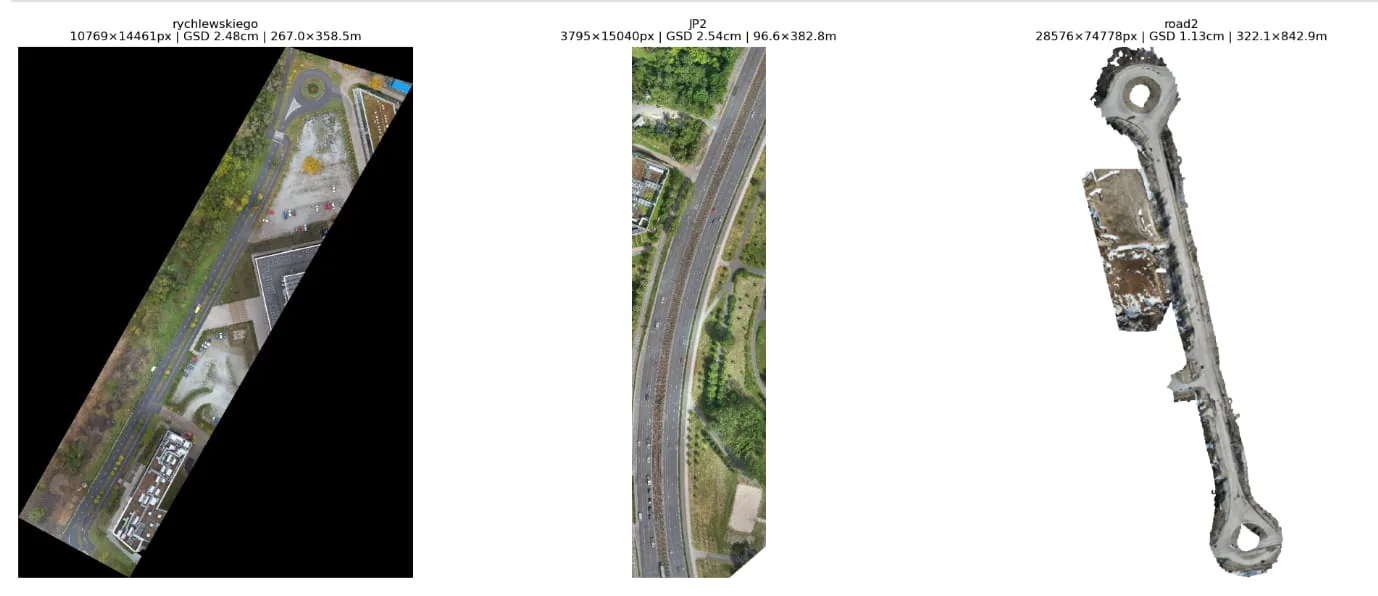
| Сцена | GSD | Площадь | Детекции | Средняя уверенность |
|---|---|---|---|---|
| rychlewskiego | 2,48 см/пикс. | 267 × 359 м | 104 | 0,25 |
| JP2 | 2,54 см/пикс. | 97 × 383 м | 49 | 0,30 |
| road2 | 1,13 см/пикс. | 322 × 843 м | 2201 | 0,30 |
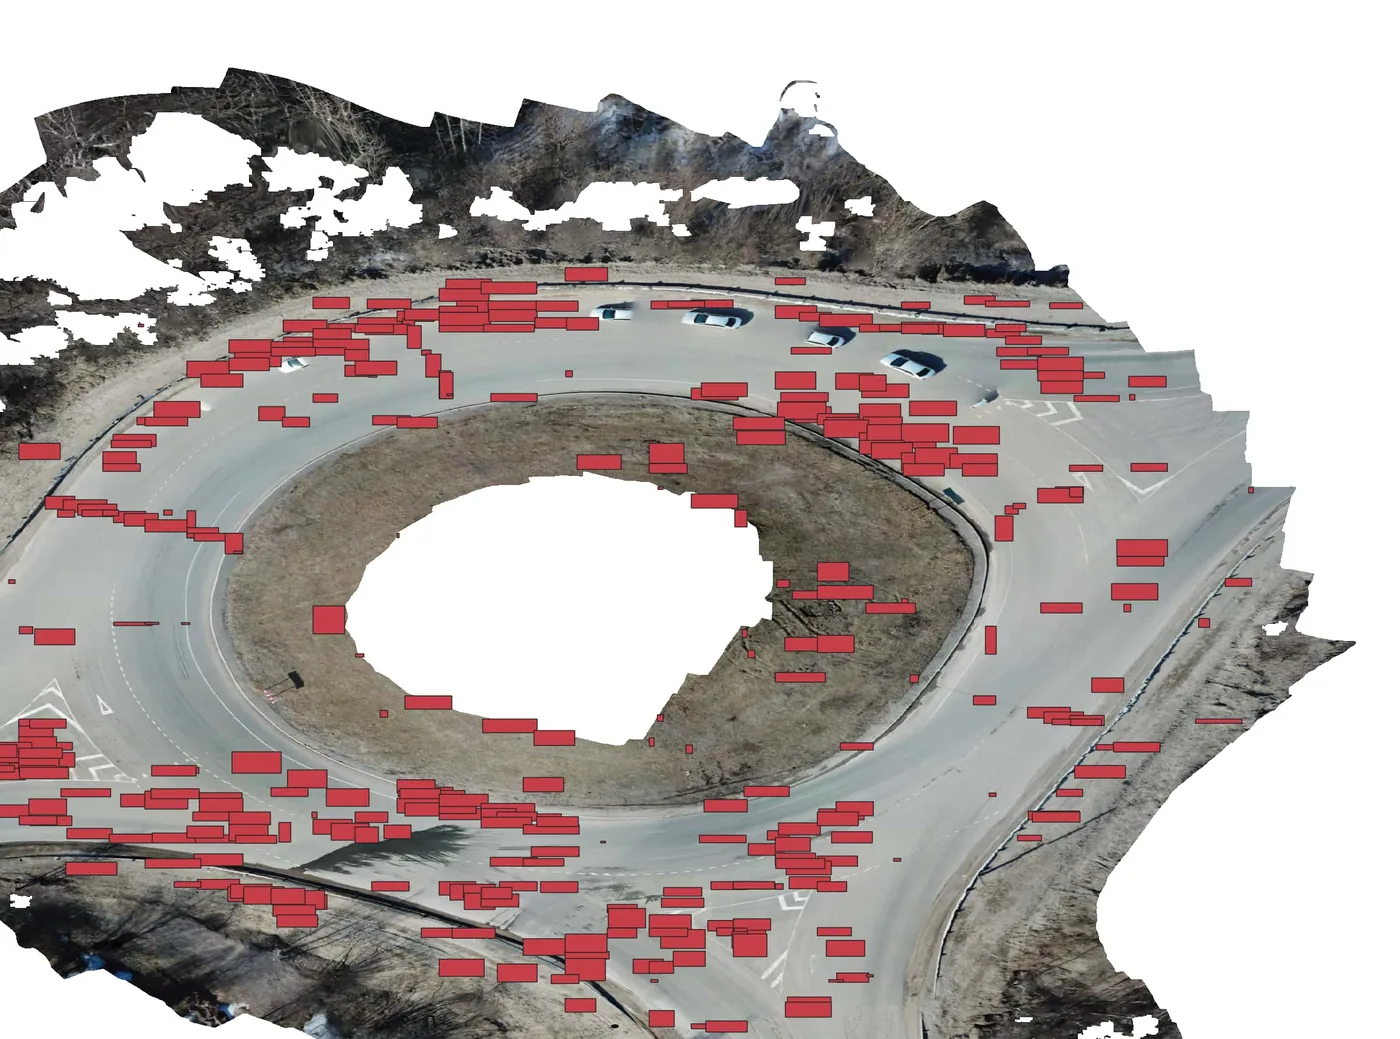
На самой большой сцене конвейер нашёл все шесть классов дефектов. Косые трещины преобладают везде, а на road2 они сосредоточены вокруг кольцевой развязки, где поворачивающие машины нагружают покрытие под углом. Детекции, загруженные в QGIS поверх исходных растров, легли на видимые повреждения покрытия, а система координат совпала с исходным файлом.
Честная цифра
Средняя уверенность на этих ортофотопланах от 0,25 до 0,30. На тестовой выборке бенчмарка она выше 0,9. Этот разрыв и есть сдвиг домена, который видно глазами: другой регион, другая высота, другая камера.
Порог уверенности 0,10 я оставил намеренно. Предполагается, что инженер проверяет детекции в ГИС, поэтому пропущенная трещина обходится дороже, чем ложная рамка, которую он отклонит за две секунды. Порог 0,25 убрал бы около 40% детекций на одной сцене, а без разметки я не мог показать, что он уберёт больше неверных рамок, чем верных.
Roadster: инструмент вместо ноутбуков
Исследовательский код живёт в ноутбуках, а тот, кто планирует ремонт дорог, их открывать не будет. Поэтому в последней части работы я обернул всё в Roadster, небольшое локальное приложение: сервер на Flask и одностраничный интерфейс.
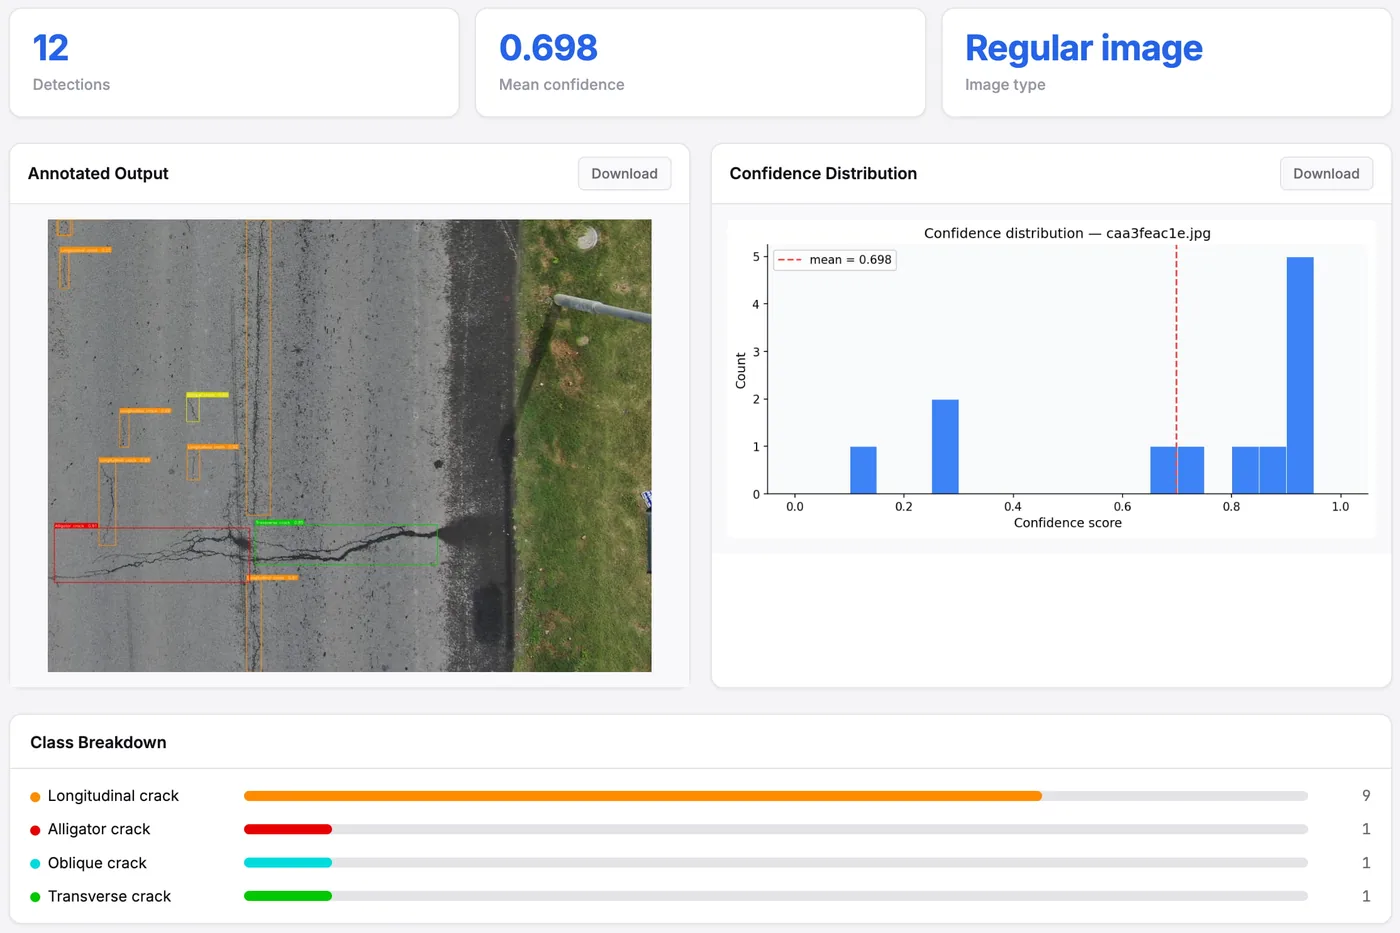
Вы выбираете одну из пяти обученных моделей, загружаете фото или GeoTIFF, задаёте ползунками пороги уверенности и IoU и получаете размеченное изображение, разбивку по классам, гистограмму уверенности и файлы CSV и GeoJSON для скачивания. Приложение само определяет ортофотоплан по наличию системы координат и аффинного преобразования и в этом случае запускает конвейер с тайлами. Инференс идёт в фоновом потоке, а страница опрашивает сервер о прогрессе.
Ограничения, прямо
- Нет разметки для реальных ортофотопланов. Я могу показать, что детекции совпадают с реальными повреждениями в QGIS, но не могу посчитать на них точность и полноту. Разметить хотя бы часть одной сцены будет самым полезным следующим шагом.
- Одна архитектура, один датасет для обучения. Порядок трёх осей может оказаться другим для другой модели или для дорог другой страны.
- Эффект разрешения не выделен отдельно, как сказано выше.
- Крупные дефекты могут разрезаться между тайлами так, что NMS между тайлами не склеит их обратно.
- Модель не знает, что такое дорога. В городских сценах она иногда срабатывает на крыши или дворы, текстура которых похожа на изношенный асфальт. Если обрезать ортофотоплан по полигонам дорог из OpenStreetMap до разбиения на тайлы, это решит большую часть проблемы без изменения модели.
Что я вынес
Метрика на бенчмарке оказалась простой частью. Настоящая работа была во всём, что лежит между файлом модели и строкой в таблице инженера: согласовать масштаб, склеить тайлы обратно, правильно получить координаты и выбрать порог для человека, который проверяет результат, а не для таблицы лидеров. Это тот же урок, что и в дата-платформах: модель, как и конвейер данных, полезна ровно настолько, насколько полезно место, куда попадает её результат.
Статьи
- A. Mustafa, M. Yu. Kataev, D. S. Efremenko. Detection of Road Defects from Unmanned Aerial Vehicles Using Machine Learning. Light & Engineering 34(3), страницы с 4 по 12, 2026.
- A. Mustafa, M. Yu. Kataev, D. S. Efremenko. Structured Training Ablation and GSD-Adaptive Orthophoto Inference for UAV-Based Pavement Defect Detection with YOLO26. Moscow University Physics Bulletin, 2026, в печати. Представлено на DLCP 2026.
Аннотации и BibTeX есть в разделе со статьями на главной странице, а все мои публикации собраны в профиле Google Scholar. Графики и рисунки здесь мои, из работы над магистерской диссертацией, на которой основаны обе статьи.