Финансовые транзакции в реальном времени: CDC, Kafka и Spark
Опубликовано · 6 мин чтения
Финансовым командам не нужны просто быстрые данные. Им нужны правильные данные, а уже потом как можно более свежие. Этот пост о конвейере, который должен был обеспечить и то и другое: захват изменений (CDC) из базы транзакций в lakehouse и хранилище данных для клиента, у которого задвоенная или потерянная транзакция совсем не ошибка округления.
Коротко
- Контекст: финтех-клиент
- Моя роль: спроектировал конвейер и руководил командой из трёх инженеров при его разработке
- Масштаб: миллионы транзакций в день
- Результат: задержка от начала до конца снизилась примерно на 60%, примерно с 15 минут до 6
- Стек: PostgreSQL, CDC-сервис на Python, Kafka, Spark Structured Streaming, Delta Lake на S3, Airflow, dbt, Amazon Redshift, FluentD, Elasticsearch и Kibana
Проблема
Клиент хранил транзакции, счета и мерчантов в PostgreSQL. Отчётность строилась на выгрузках по
расписанию каждые 15 минут: маленькие таблицы целиком, большие по полю updated_at. Это работало,
пока не перестало:
- Финансовая команда и команда рисков всегда отставали. Дашборды отставали от бизнеса на интервал выгрузки плюс время загрузки, а проверки на аномалии шли по уже устаревшим данным.
- Выгрузки нагружали продакшен. Каждый запуск обращался к основной базе, и запросы становились тяжелее по мере роста таблиц.
- Удаления и промежуточные состояния не было видно. Опрос по
updated_atвидит последнюю версию строки, а не каждое изменение, и никогда не видит физическое удаление. В финансах отменённая транзакция, которая тихо исчезает, как раз и вызывает вопросы у аудиторов.
Ограничения
То, что я записал их заранее, определило все последующие решения:
- Ничего не терять и ничего не считать дважды. Платёж, учтённый дважды, хуже, чем дашборд, отстающий на несколько минут.
- Не мешать основной базе. Исходная база обслуживала продукт, и аналитика не должна была её замедлять.
- Оставить аналитиков там, где они работают. Они уже работали в Redshift, с годами накопленного SQL и дашбордов.
- Чувствительные поля не выходят за пределы. Данные карт и персональные данные никогда не должны попадать в запросы аналитиков.
- Любую цифру можно объяснить позже. Если через три месяца цифру поставят под сомнение, мы должны показать, как она получена.
Архитектура
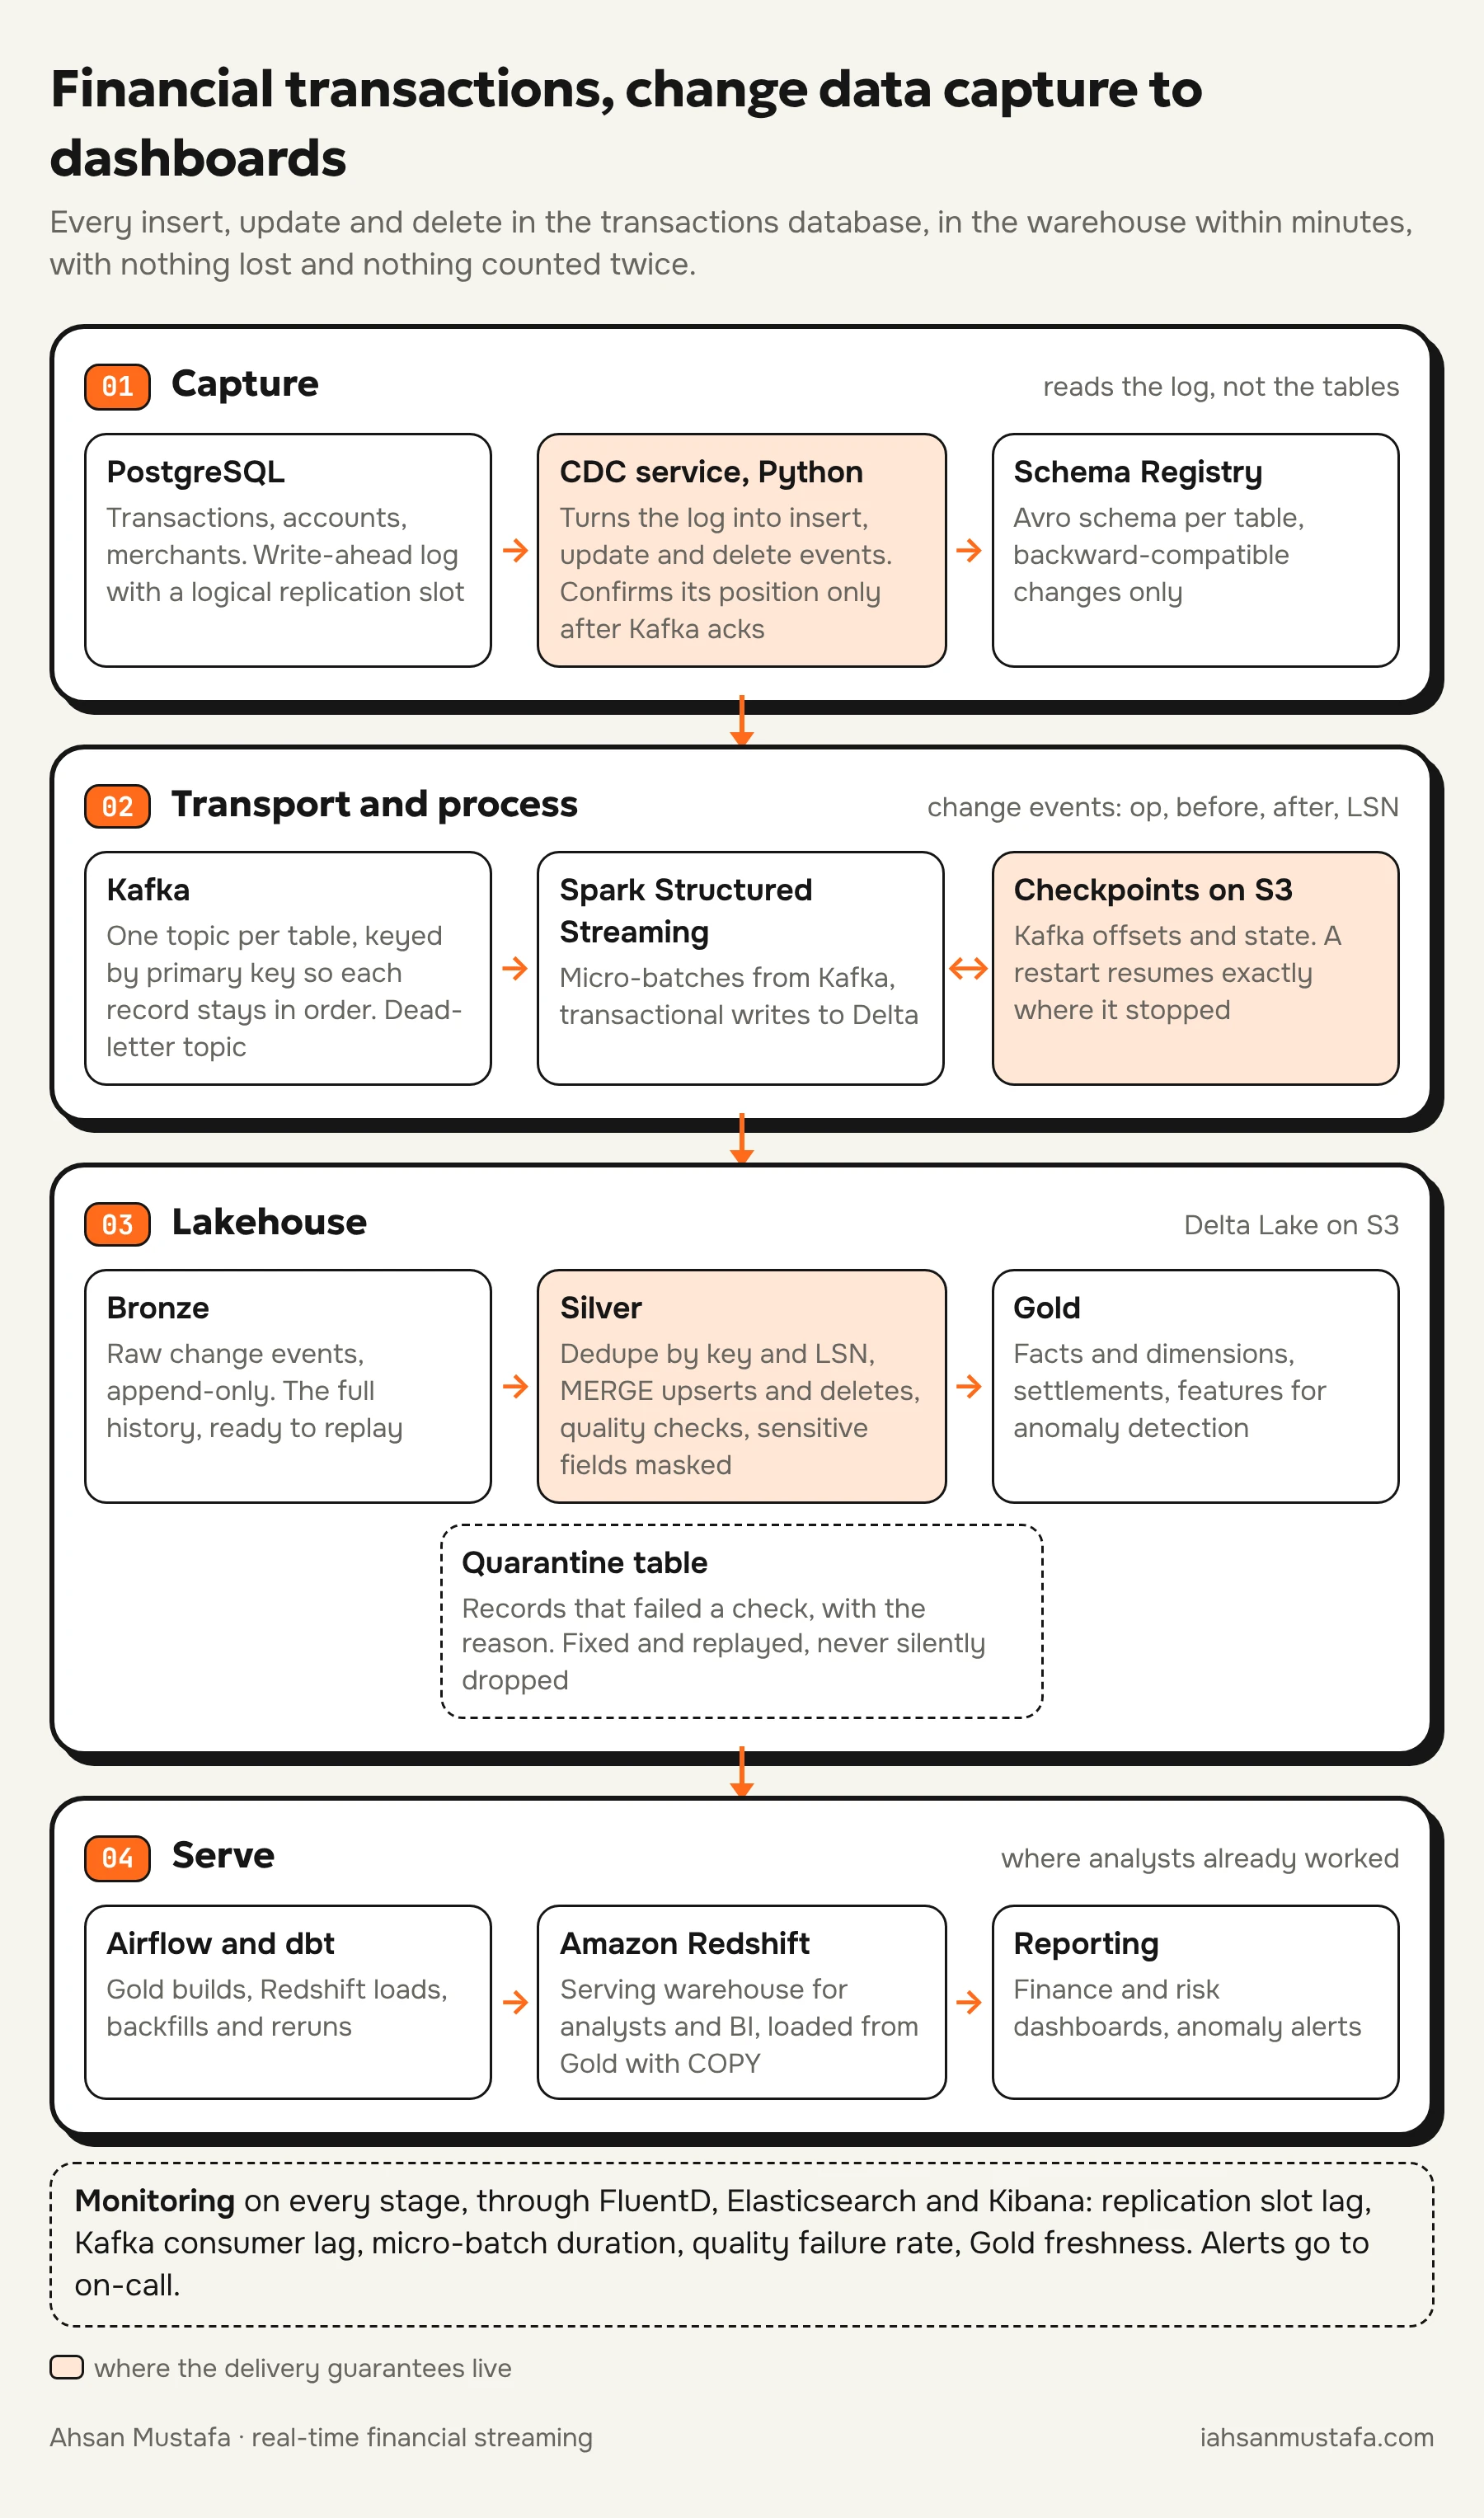
Одним предложением: сервис на Python читает каждое изменение из журнала предзаписи Postgres и публикует его в Kafka; Spark без изменений складывает события в таблицу Bronze в Delta на S3; Silver превращает их в чистое текущее состояние; в Gold лежат бизнес-модели; а Redshift отдаёт их тем, кто и так там работал.
Захват
CDC-сервис читает журнал предзаписи (WAL) через слот логической репликации. Каждое зафиксированное изменение становится событием с типом операции, строкой до и после изменения и номером в журнале (LSN). Сервис подтверждает свою позицию в журнале только после того, как Kafka подтвердила получение события, поэтому при сбое изменение не может потеряться.
Почему свой сервис на Python, а не Debezium? Клиент не разрешал кластер Kafka Connect в этой сети, а чувствительные поля нужно было токенизировать до того, как событие покинет её. Сегодня я бы по умолчанию выбрал Debezium, а свой CDC писал бы только при таком же ограничении.
Передача
В Kafka один топик на каждую таблицу, ключ сообщения равен первичному ключу. Все изменения одного счёта или одной транзакции попадают в одну партицию и идут по порядку. Общий порядок по всем записям не нужен и стоил бы пропускной способности. Схемы хранятся в Schema Registry в формате Avro с обратной совместимостью: новая колонка, допускающая NULL, проходит, ничего не ломая, а ломающее изменение приходится планировать.
Обработка и запись
Spark Structured Streaming работает на Amazon EMR и читает Kafka микробатчами каждые 30 секунд. Он дописывает события в Bronze ровно в том виде, в котором они пришли. Смещения Kafka и коммит в Delta сохраняются вместе через контрольные точки на S3, поэтому перезапущенная задача не пропускает батч и не записывает его дважды.
В Silver события становятся состоянием. Здесь записи дедуплицируются по первичному ключу и LSN,
вставки, обновления и удаления применяются через MERGE, работают проверки качества и маскируются
чувствительные поля. Записи, не прошедшие проверку, например без валюты или с отрицательной суммой
там, где она невозможна, уходят в таблицу карантина с указанием причины, а поток не
останавливается.
В Gold лежит то, что читает бизнес: факты и измерения, взаиморасчёты и признаки для поиска аномалий.
Выдача
Airflow и dbt строят модели Gold, загружают их в Redshift через COPY и отвечают за дозагрузки
и перезапуски. Аналитики сохранили своё хранилище и свои дашборды; изменилось только то, насколько
свежими стали данные в нём.
Решения и их цена
У каждого решения здесь была своя цена. Вот те, которые я стал бы защищать первыми.
CDC по журналу вместо опроса таблиц. Чтение журнала почти не нагружает основную базу, ловит каждое изменение, включая удаления и промежуточные состояния, и доставляет его через секунды после коммита. Цена: слот репликации удерживает журнал на основной базе, пока его не прочитают. Если CDC-сервис остановится, диск основной базы заполнится. Отставание слота отслеживается, на него настроены оповещения, а лимит на удерживаемый журнал служит последней линией защиты.
Доставка «хотя бы один раз» с идемпотентным слиянием вместо «ровно один раз» на всём пути. CDC-сервис подтверждает позицию только после подтверждения от Kafka, поэтому ничего не теряется. После сбоя события могут прийти повторно, поэтому Silver сливает их по ключу и оставляет наибольший LSN, и дубликат ничего не меняет. Цена: каждая запись ниже по потоку должна быть идемпотентной. Взамен система становится намного проще для понимания и тестирования.
Bronze только на добавление как источник истины. Исходная база хранит только текущее состояние. Bronze хранит каждое изменение в том виде, в каком оно пришло, поэтому ошибку в Silver или Gold исправляют повторным проигрыванием Bronze, а не новой выгрузкой из продакшена. Это ещё и журнал аудита, который нужен регулируемому бизнесу. Цена: объём хранения растёт постоянно, если старые партиции не переносить в более дешёвое хранилище.
Карантин вместо остановки потока. Одна битая запись не должна останавливать миллионы хороших. Цена: у очереди карантина должен быть владелец, иначе она тихо разрастается. Её размер отслеживается как метрика, и за ней закреплён ответственный.
Маскирование в Silver. Аналитики никогда не видят сырые данные карт и персональные данные. Цена: в Bronze сырые значения остаются, поэтому у него самые строгие правила доступа на платформе.
Redshift как слой выдачи рядом с lakehouse. Lakehouse отвечает за повторное проигрывание, дешёвое хранение и признаки для моделей; Redshift отвечает за быстрый параллельный SQL для тех, кто уже им пользуется. Цена: Gold существует в двух местах. Запросы напрямую к Delta убрали бы одну копию, но тогда важнее было не менять инструменты аналитиков.
Что пошло не так
Через три недели после запуска, в пятницу вечером, CDC-сервис упал на числовом значении, которое его декодер не умел обрабатывать. Он перезапустился, снова упал на той же записи и так продолжалось все выходные. Ничего не потерялось, потому что слот репликации сохранил каждое изменение, но в этом и проблема: основная база тоже их сохранила. К воскресенью журнал предзаписи вырос примерно на 300 ГБ, и на основной базе сработало оповещение о заполнении диска на 80%.
Исправление состояло из трёх частей. Декодер научился обрабатывать недостающий тип, а всё, что он
по-прежнему не может разобрать, теперь уходит в топик недоставленных сообщений, а не роняет сервис.
Отставание слота получило собственное оповещение с порогом намного ниже того, где диск становится
риском. А max_slot_wal_keep_size теперь ограничивает удерживаемый журнал, так что в худшем случае
придётся проиграть данные из Bronze, а продукт не остановится.
Урок шире, чем эта ошибка: в CDC-конвейере база, из которой вы читаете, входит в зону поражения. Мониторинг должен следить за источником, а не только за конвейером.
Результаты
- Задержка: дашборды стали отставать примерно на 6 минут вместо 15, то есть примерно на 60% меньше.
- Нагрузка: запросы выгрузки к основной базе полностью прекратились.
- Корректность: ежедневные сверки числа строк и контрольных сумм между источником и Silver совпадали для всех таблиц начиная со второго месяца.
- Восстановление: ошибка в логике стала повторным проигрыванием, а не инцидентом. За первый квартал мы дважды перестроили Silver и Gold из Bronze, не трогая продакшен.
Что я бы сделал иначе сегодня
- Debezium по умолчанию. Если нет ограничения, как описано выше, я бы взял поддерживаемый коннектор и потратил время на данные.
- Меньше копий. Я бы попробовал строить BI прямо на Delta, прежде чем добавлять второе хранилище.
- Тесты на повторное проигрывание с первого дня. Остановить CDC-сервис посреди потока, перезапустить и проверить, что в Silver нет ни потерь, ни дубликатов, в CI, при каждом изменении логики слияния.
- Контракты данных с командой источника. Правила для схем работали, но работали потому, что люди их помнили. Письменный контракт с автоматическими проверками обходится дешевле, чем ещё один инцидент.
Что я вынес
Потоковую обработку легко нарисовать и трудно сделать надёжной. Стрелки на схеме оказываются простой частью. Работа в скучных гарантиях между ними: когда подтверждать, как дедуплицировать, где хранится история и кто первым заметит, что что-то остановилось.